0. Der Lehrplan
Lehrplan (ca. 9 Stunden)
Die Schülerinnen und Schüler …
- erläutern die Struktur und Funktionsweise des Internets sowie die damit verbundene Adressierung von Geräten.
- strukturieren Kommunikationsvorgänge im Internet in aufeinander aufbauende Schichten und beschreiben so die Übermittlung elektronischer Daten; dabei erlangen sie ein grundlegendes Verständnis für die Bedeutung von Protokollen.
- beschreiben das Zusammenspiel von Client und Server bei Webanwendungen, z. B. bei einer Fahrplanauskunft.
- erläutern Chancen und Risiken des Internets, beurteilen ihren eigenen Umgang mit dessen Diensten und reflektieren dabei, wodurch der Schutz persönlicher Daten erhöht und die Gefahr des Missbrauchs minimiert werden kann.
Inhalte zu den Kompetenzen:
- Struktur und Funktionsweise des Internets: Client, Server, Router; Adressierung im Internet (MAC-Adresse, IP-Adresse, DNS, Port)
- Schichtenmodell: Anwendungsschicht, Transportschicht, Vermittlungsschicht, Netzzugangsschicht
- Protokolle zur Beschreibung der Kommunikation im Internet
- WWW als Beispiel eines Dienstes, Browser, HTML, Cookies
- Datenschutz
Für 9 Stunden ist das ziemlich viel. Ich habe schon voller Schwung und mit der Erfahrung aus dem letzten Schuljahr alles verplant (für deutlich mehr Stunden; ich werde kürzen müssen) und vor allem diesen Lehrplanabschnitt 3 vorangestellt, um erst von diesem aus später zu den weiteren zu gelangen.
Stunde 1: Das Client-Server-Prinzip im Web
1. Das Client-Server-Prinzip
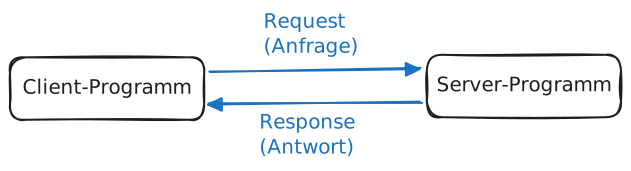
- Client-Programm (auf Rechner, ebenfalls Client genannt) stellt Anfrage an Server-Programm (auf Server-Rechner) und erhält Antwort.
Das Client-Server-Prinzip ist für viele Vorgänge bei Computern und vor allem in Netzwerken wichtig. Es ist eigentlich sehr einfach: Ein Client (ein Programm, das auf einem Rechner läuft, der ebenfalls Client genannt wird) stellt eine Anfrage (Request) an einen Server (ein Programm, das auf einem Rechner läuft, der ebenfalls Server genannt wird) und erhält darauf eine Antwort (Response).
Ein Web-Server ist ein Programm, das auf Anfrage Webseiten ausliefert.
Ein E-Mail-Server ist ein Programm, das auf Anfrage E-Mail versendet oder empfängt.
Ein Drucker-Server ist ein Programm, das Druckaufträge entgegennimmt und verarbeitet.
Ein Datei-Server ist ein Programm, das auf Anfrage Dateien verschickt.
Damit die Kommunikation ohne Missverständnisse abläuft, müssen in allen Fällen sowohl die Anfrage als auch die Antwort einem bestimmten Schema, einem Protokoll, entsprechen.
Wir werden uns später Anfrage und Antwort bei einem Webserver genauer anschauen.
2. Beispiel: Webseiten-Anfrage
2.1 Anfrage und Ergebnis im Browser
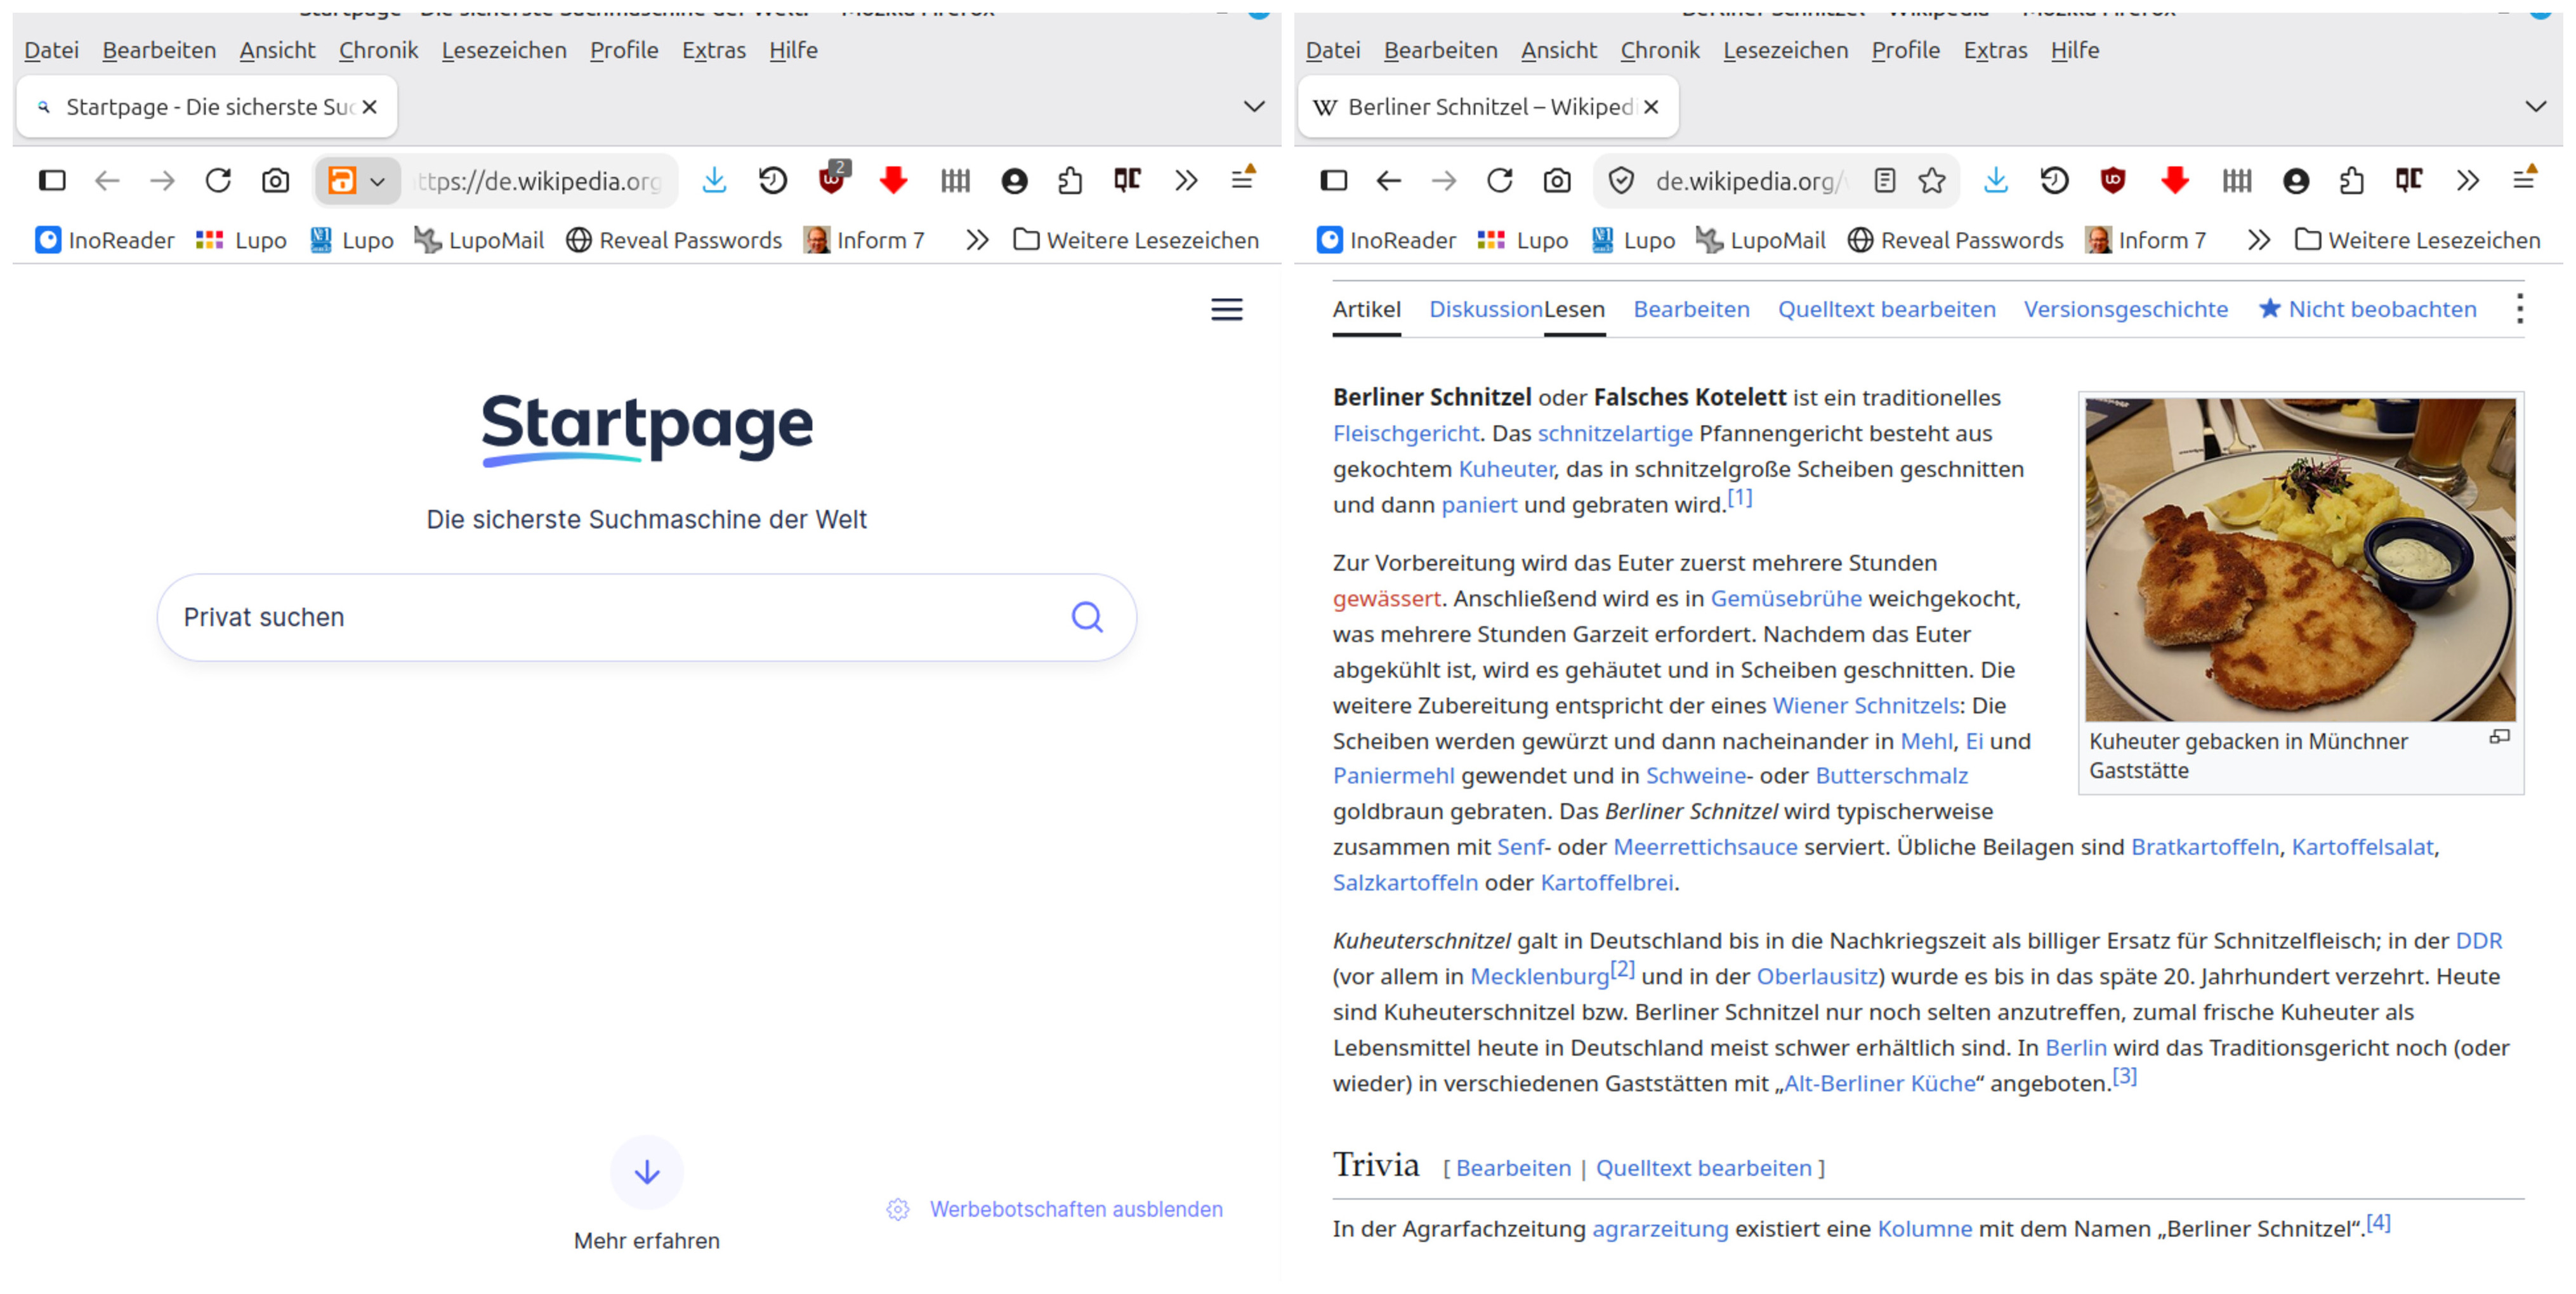
Man stellt eine Anfrage (links) und erhält eine Antwort (rechts).
2.2 Webseite ohne CSS und Bilder
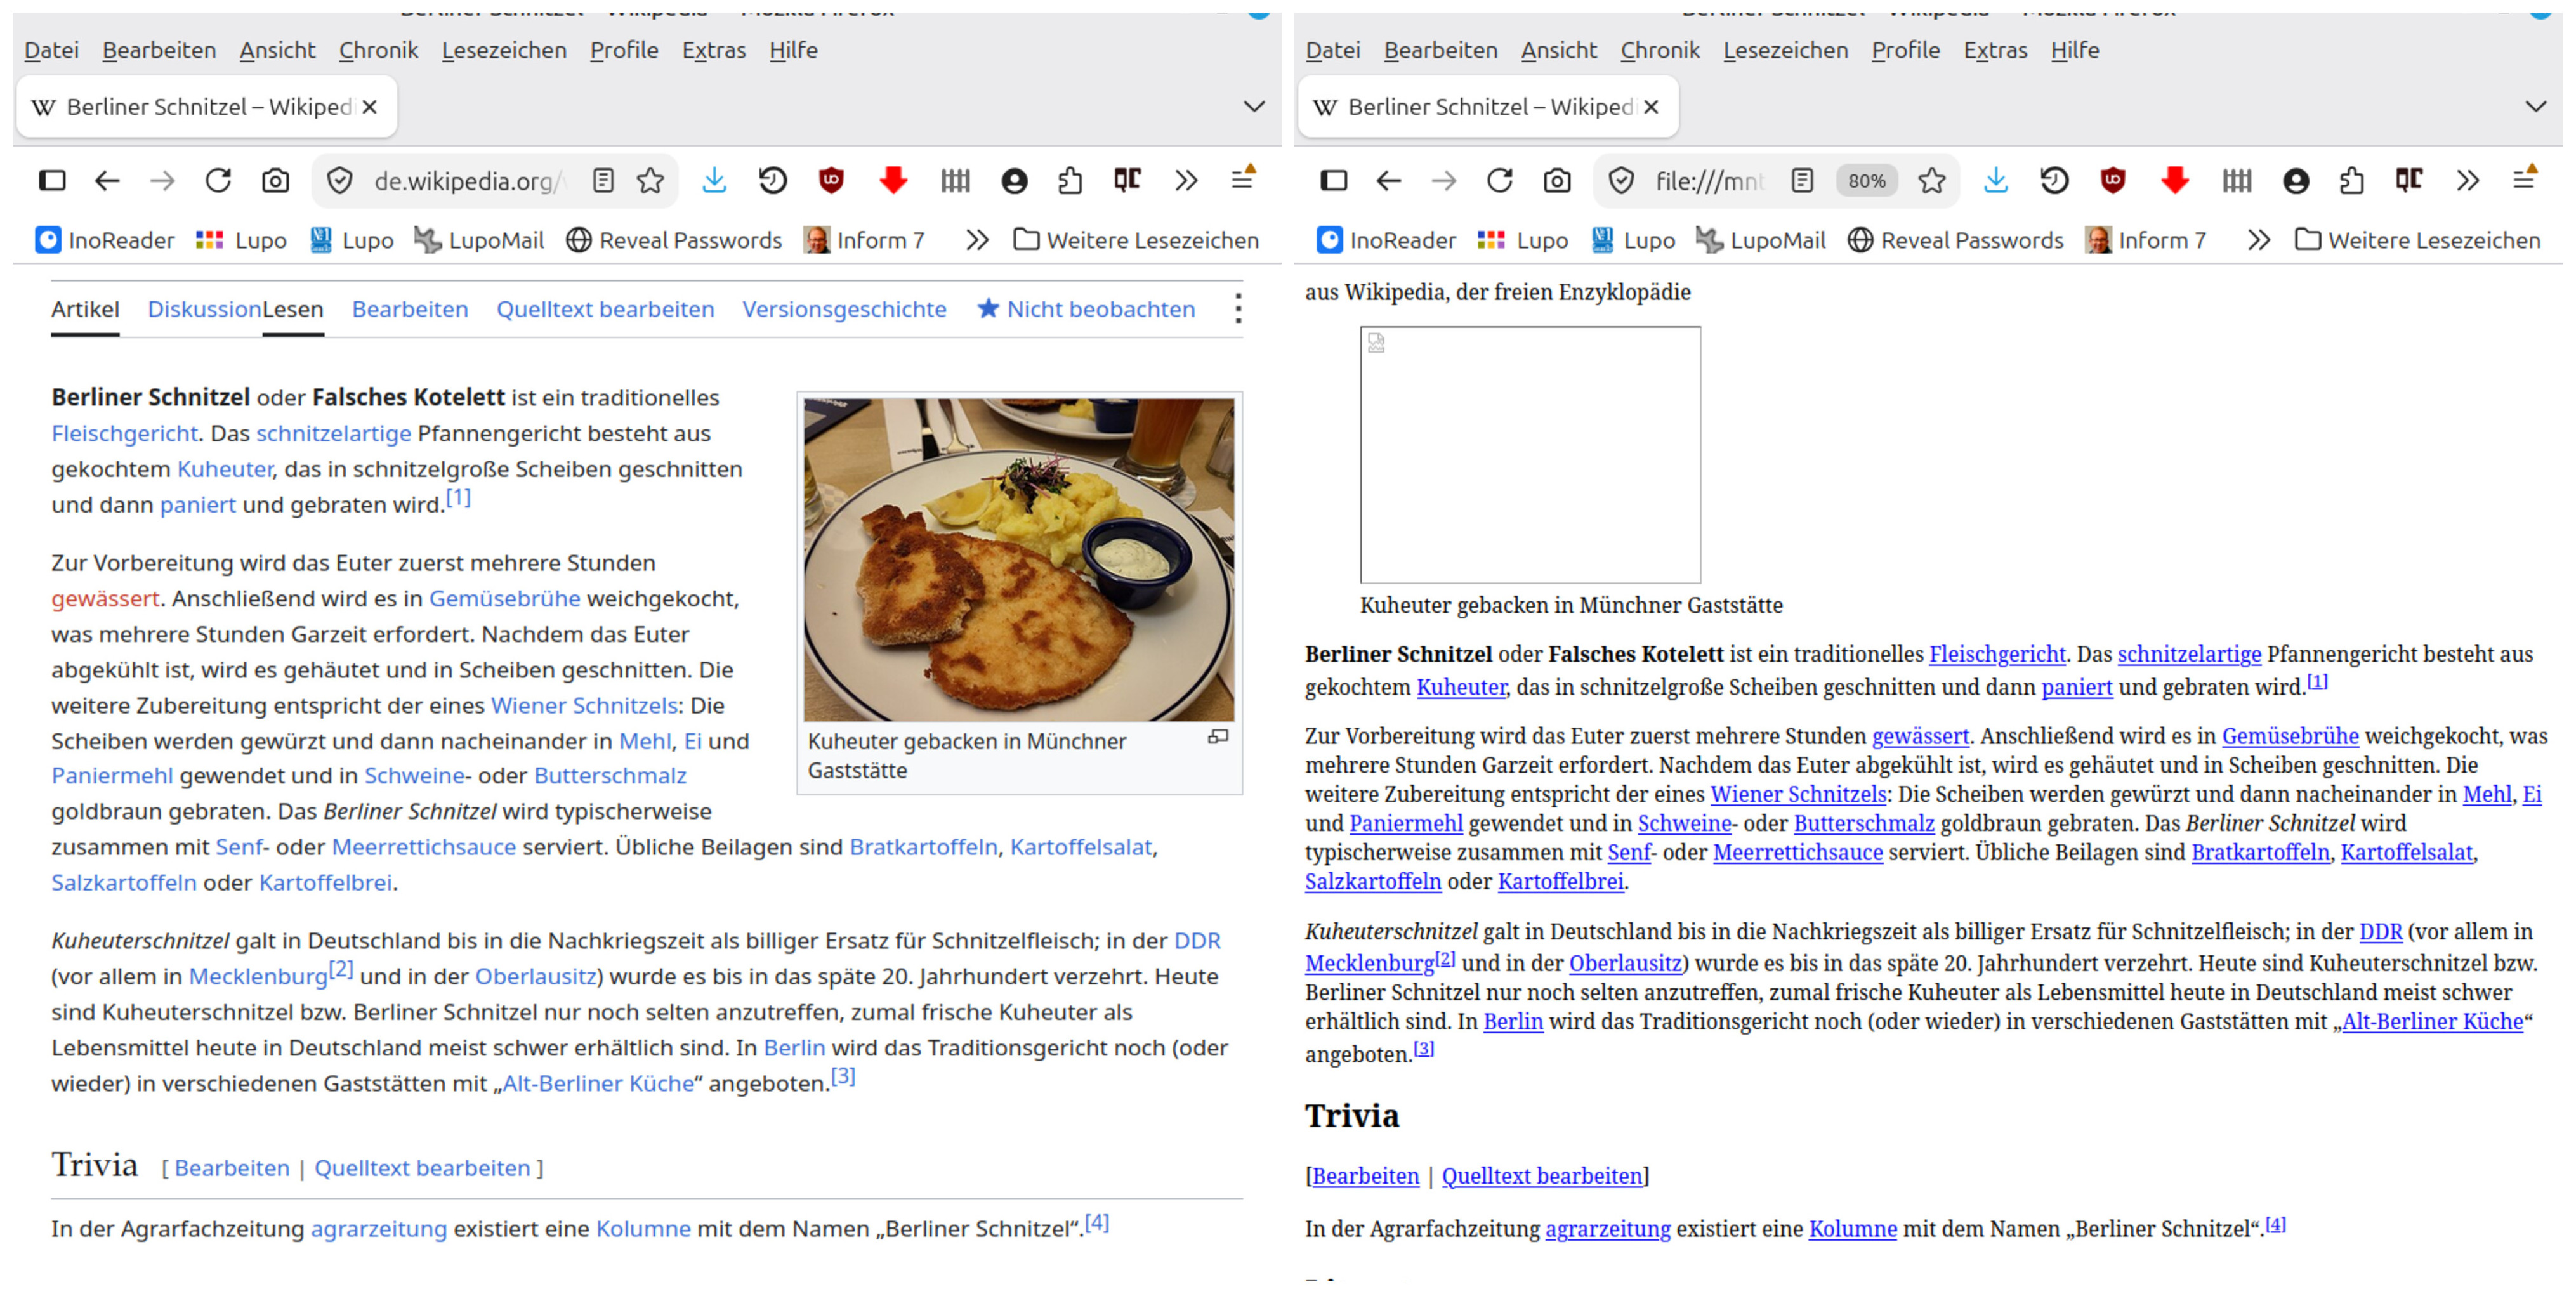
Manchmal sehen Webseiten nicht so aus wie links, sondern wie rechts: Da fehlt etwas. Rechs ist das Bild nicht mitgeladen worden, etwa weil die Verbindung abgebrochen oder zu schlecht ist, und auch das Design sieht unvollständig oder jedenfalls anders aus.
Das liegt daran, dass zu einem Webseitenaufruf nicht nur eine Anfrage (und Antwort) gehört, sondern üblicherweise mehrere Ressourcen angefragt werden. Wenn da etwas dazwischen kommt, kommt es zu solchen unvollständigen Darstellungen.
2.3 Was tatsächlich geschieht
Meist mehrfache Anfragen und Antworten, nämlich:
- die HTML-Datei (=Inhalt und Struktur) mit Informationen zu weiteren Dateien, etwa:
- CSS-Dateien (=Design)
- Bilddateien
- JavaScript-Dateien (=Programm)
- Dateien mit eingebetteter Werbung
- Cookies
- …
Wenn man eine Webseite aufruft, wird zuerst eine HTML-Seite angefragt und zurückgegeben. In der 7. Klasse erstellt man selber HTML-Seiten, vielleicht erinnerst du dich. So eine HTML-Seite ist das das Grundgerüst, sie enthält meistens, aber nicht unbedingt, den Text der Seite, die Überschriften, und Informationen über weitere Dateien, die dann in weiteren Aufrufen angefragt und geladen werden. Wenn alle diese Dateien geladen sind, kann die Seite vollständig dargestellt werden.
Diese zusätzlichen Dateien sind vor allem:
- Bildddateien
- eine oder mehrere CSS-Dateien, die Informationen über das Design enthalten (Schriftart, Schriftfarbe, Zeilenabstand, Platzierung der Elemente).
- JavaScript-Dateien, das sind kleine Programme, die auf dem Rechner der Anfragenden ausgeführt werden und für mehr Interaktivität sorgen
- Dateien mit eingebetteter Werbung (wäre es nicht schön, wenn man die, und nur die, blockieren könnte? Man kann!)
- Cookies, also kleine Textschnipsel, die Information über den Webseitenbesuch enthalten und die in deinem Browser gespeichert werden
Die Aufzählung ist unvollständig, es kann noch mehr geben.
Für Interessierte: Unter https://csszengarden.com/ kann man mit CSS experimentieren und schauen, wie die gleiche HTML-Datei unterschiedlich dargestellt wird, je nach ausgewähltem CSS.
2.4 Exkurs: Kommandozeile und curl
- suche und starte das Programm
cmd(Kommandozeile/ Terminal/ Eingabeaufforderung/ Konsole) - gib dort diesen Befehl ein:
curl https://www.sueddeutsche.de - versuche auch diese Befehle, und weitere Adressen:
curl spiegel.decurl www.spiegel.decurl https://www.spiegel.de
Jetzt geht es ums Ausprobieren. Meistens benutzt man einen Browser (Firefox, Safari, Edge, Chrome), um Webseiten anzufragen und darzustellen. Weil wir uns das etwas genauer anschauen wollen, benutzen wir das Kommandozeilenwerkzeug curl.
Die Kommandozeile (auch Terminal) startest du, indem du das Programm cmd suchst. So heißt es bei Windows, aber du findest es auch bei Linux unter diesem Namen; bei MacOS heißt es Terminalund ist bei den Dienstprogrammen zu finden.
Die Kommandozeile ist rein textbasiert: Man tippt Text ein und kriegt als Antwort auch nur Text. Dennoch kann man dort programmieren und Textbearbeitung machen und vieles mehr; als Computer anfingen, gab es nichts anderes als die Kommandozeile.
Du sollst das Programm curl kennenlernen und benutzen. Mit curl gefolgt von einer Adresse forderst du die Ressource an, die unter dieser Adresse von einem Webserver bereitgestellt wird.
Bei curl wird aber nur die angeforderte Ressource geladen, also etwa die HTML-Seite; die weiteren Dateien, die in ihr eventuell angegeben werden, werden nicht geladen.
Die Adresse kann verschiedene Formate haben, dazu später mehr. Es macht jedenfalls einen Unterschied, ob du http://oder https:// oder nichts voranstellst, ob da www steht oder nicht. Das führt dazu, dass manchmal keine oder eine unerwartete Antwort kommt.
(Ein paar Schüler wussten doch tatsächlich, wie man die Farbeinstellungen der Konsole ändert, also etwa auf cooles grün auf schwarz statt wie voreingestellt weiß auf schwarz. Das sprach sich schnell herum und brachte Respekt.)
2.5 Fehlermeldungen
- 301 Moved Permanently
curl luitpold-gymnasium.eu→ keine Antwortcurl http://luitpold-gymnasium.eu→ keine Antwortcurl https://luitpold-gymnasium.eu→ nur hier Antwort!
äufig erhält man als Antwort statt der gewünschten Ressource nur einige wenige Zeilen, an deren Anfang etwas steht wie 301 Moved Permanently. Das heißt, dass die gewünschte Adresse nicht mehr aktuell und an eine andere Adresse umgezogen ist. Manchmal kommt auch einfach gar keine Antwort. Manchmal ist die neue Adresse sichtbar angegeben, manchmal nicht.
Im Browser wird automatisch zu der anderen Adresse gewechselt; curl macht das nicht.
Ein Beispiel:
curl sueddeutsche.deist unvollständigcurl www.sueddeutsche.deist besser, weil zufälligerweise, aber oft, die Adresse mitwwwbeginnt, aber immer noch unvollständigcurl https://www.sueddeutsche.deist erst die Angabe, die zum gewünschten Ergebnis führt
2.6 Mehr zu curl
Mit:
curl https://www.sueddeutsche.de > seite.html
leitest du die Ausgabe statt auf den Bildschirm in eine Datei um (Name frei wählbar, Webseiten am besten mit .html hinten).
Mehr Informationen zur Kommandozeile oder zu curlstehen in einer separaten Datei. Hier nur kurz: Wenn man das Ergebnis nicht als Text angezeigt bekommen will, sondern als Datei speichern will, schreibt man, als eine von mehreren Möglichkeiten:
curl https://www.sueddeutsche.de > seite.html speichert die Ausgabe in einer Datei namens „seite.html“. Den Dateinamen kannst du dir aussuchen, Webseiten enden Konventionell auf „.html“.
curl -v https://sueddeutsche.degibt dir mehr Informationen darüber, was im Hintergrund geschieht.
curl wttr.in/colognecurl wttr.in/Dún+Laoghairecurl wttr.in/münchencurl wttr.in/münchen?0curl de.wttr.in/münchen?0curl wttr.in/-78.46,106.79 (GPS-Koordinaten)
Von dieser schönen Seite habe ich erst nach der Stunde erfahren, das hole ich nächstes Mal schnell nach. Kann man gleich anknüpfen: Von welchem Ort erhält man das Wetter, wenn man nur curl wttr.in eingibt, und warum?
(Fortsetzung folgt. Dann mit HTTP und anderen Protokollen.)
Schreibe einen Kommentar